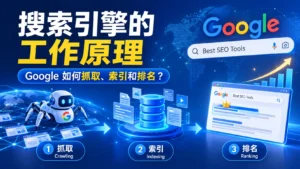

你有没有想过这样一个问题:
当你打开 Google,在搜索框中输入“Best Running Shoes”(最好的跑鞋),按下回车键后,为什么 Google 能在不到一秒的时间里,从互联网上海量的网页中,找到几十万甚至上百万条相关结果?
这些网页是从哪里来的?Google 是怎么知道哪个网页更值得推荐?为什么有些网站排名靠前,而有些网站即使内容很好,也很难被搜索到?
要理解这些问题,我们首先需要了解搜索引擎的基本工作原理。
简单来说,Google 搜索引擎主要通过三个核心步骤工作:抓取(Crawling)、索引(Indexing)和排名与展示(Serving / Search Ranking)。
可以把 Google 想象成一个超级图书馆:
- 抓取:图书馆工作人员到处收集书籍。
- 索引:工作人员阅读书籍、整理内容,并建立目录。
- 排名与展示:当读者提出问题时,图书馆根据问题,从藏书中挑选最相关、最有用的内容。
接下来,我们就以 Google 为例,一步一步拆解搜索引擎是如何工作的。
一、第一步:抓取(Crawling)——Google 如何发现网页?
首先,Google 必须知道互联网上有哪些网页,才能决定是否把它们展示给用户。
但互联网上每天都有大量新网站、新文章和新页面产生,而且没有一个统一的网站目录,能够告诉 Google 所有网页的位置。
那么,Google 怎么找到这些网页呢?
答案是:通过自动化程序,也就是搜索引擎爬虫(Crawler)。
1. 什么是 Googlebot?
Googlebot 是 Google 用来发现和抓取网页的自动化程序,也常被称为:
- Crawler(爬虫)
- Spider(蜘蛛)
- Bot(机器人)
你可以把 Googlebot 想象成一个不知疲倦的图书管理员,它每天都在互联网上浏览网站、访问网页、发现新内容。
它主要通过以下几种方式发现网页:
方式一:通过已有网页中的链接发现新网页
假设你建立了一个网站,里面有一篇文章:
https://example.com/seo-guideGooglebot 之前已经访问过这个网站。
后来,你又发布了一篇新文章:
https://example.com/keyword-research并且在原来的 SEO 教程文章中添加了指向新文章的链接。
当 Googlebot 再次访问旧文章时,就可能顺着这个链接发现新文章。
这就是为什么网站内部链接(Internal Links)非常重要。
方式二:通过其他网站的外部链接发现网页
假设你的网站刚刚上线,Google 还不知道它的存在。
如果一个已经被 Google 发现的网站,在文章中添加了指向你网站的链接,那么 Googlebot 就有机会通过这个链接找到你的网站。
这也是外部链接(Backlinks)在 SEO 中具有价值的原因之一。
方式三:通过 Sitemap 网站地图发现网页
Sitemap(网站地图)是一个专门提供给搜索引擎的文件,通常使用 XML 格式。
它相当于给 Google 提供一份网站页面清单,告诉 Google:
- 我的网站有哪些重要页面?
- 这些页面的 URL 是什么?
- 哪些页面最近更新过?
例如:
https://example.com/sitemap.xml网站管理员可以通过 Google Search Console 提交 Sitemap,帮助 Google 发现网站中的页面。
需要注意:提交 Sitemap 不代表 Google 一定会抓取或收录这些页面,它只是帮助 Google 发现网页的一种方式。
2. Googlebot 找到网页后会做什么?
当 Googlebot 发现一个网页后,会尝试访问这个网页,并下载相关内容。
例如:
- 网页中的文字内容
- HTML 代码
- 图片及相关信息
- 网页中的链接
- 页面标题和描述等信息
如果网页使用 JavaScript 动态加载内容,Google 还可能需要进一步渲染页面,才能理解最终展示出来的内容。
不过,并不是所有发现的网页都会被抓取。
例如:
- 网站服务器无法正常访问。
- 网站通过 robots.txt 限制了爬虫访问。
- 页面需要登录才能查看。
- 网站响应异常,无法正常加载。
Google 会根据自己的抓取系统决定访问哪些网站、访问频率以及每次抓取多少页面。
对网站运营者来说,这一步最重要的事情就是:让 Googlebot 能够找到你的网站,并且能够正常访问你的网页。
二、第二步:索引(Indexing)——Google 如何理解和存储网页?
Googlebot 抓取网页之后,并不意味着这个网页就会出现在 Google 搜索结果中。
接下来还有一个非常重要的步骤:索引。
1. 什么是搜索引擎索引?
索引(Indexing)可以简单理解为:Google 阅读抓取到的网页,分析网页内容,并将有价值的信息整理到自己的数据库中。
这个数据库就叫作 Google Search Index(Google 搜索索引)。
我们继续用图书馆举例。
假设图书馆收集了 100 万本书,但这些书全部堆放在仓库里,没有分类、没有目录。
当有人想找一本关于 SEO 的书时,工作人员就只能一本一本地翻找,效率非常低。
所以,图书馆必须给书籍分类、建立目录,方便快速查找。
Google 的索引系统也是类似的原理。
2. Google 如何分析一个网页?
Google 不只是简单地保存网页,它还需要理解网页的主题和内容。
例如,你发布了一篇文章:
《SEO 新手入门指南:如何做好 Google SEO?》
Google 在处理这个页面时,可能会分析以下内容:
| 分析对象 | Google 可能关注的内容 |
|---|---|
| Title(标题) | 这篇文章主要讲什么? |
| 正文内容 | 文章讨论了哪些主题? |
| H1、H2 标题 | 页面内容如何组织? |
| 图片 | 图片内容及相关替代文本是什么? |
| 内部链接 | 页面与网站其他内容有什么联系? |
| 外部链接 | 页面引用了哪些外部资源? |
| 页面语言 | 页面使用什么语言? |
| Canonical | 哪个 URL 是这组相似页面中的规范版本? |
通过这些信息,Google 可以更好地理解网页内容。
例如,它可能识别出:
- 主题:Google SEO
- 内容类型:教程
- 目标读者:SEO 初学者
- 相关概念:关键词研究、网站收录、外链、排名优化
这里需要注意:上面是帮助理解的简化示例,并不是 Google 对网页建立索引时公开的固定分类格式。
3. 为什么有些网页抓取了,却没有被收录?
这是很多新手站长都会遇到的问题。
比如,你在 Google Search Console 中发现:
- Google 已经发现了这个页面。
- Googlebot 也已经抓取了这个页面。
- 但是,这个页面依然没有出现在 Google 的索引中。
为什么?
因为抓取(Crawling)和收录(Indexing)是两个不同的过程。
Google 可能因为以下原因没有收录某个页面:
- 页面内容质量较低,缺乏独特价值。
- 页面与其他网页高度重复。
- 页面设置了 noindex,告诉搜索引擎不要将其收录。
- 页面内容无法正常读取或理解。
- 网站技术结构存在问题。
另外,即使网页符合技术要求,Google 也不保证一定会将其收录。
4. 如何检查网页是否被 Google 收录?
最简单的方法是使用 Google 搜索中的 site: 指令。
例如:
site:example.com它可以帮助你查看 Google 已收录的该网站页面。
如果想检查某一个具体页面:
site:example.com/seo-guide不过,site: 搜索结果并不是完整、精确的索引统计数据。
更专业的方法是使用 Google Search Console。
在 Search Console 中,你可以通过网址检查工具(URL Inspection)查看:
- Google 是否发现了这个 URL。
- Google 是否抓取了这个 URL。
- 页面是否被编入索引。
- 如果没有收录,可能是什么原因。
- Google 选择的规范 URL 是什么。
对网站运营者来说,这一步最重要的事情就是:让 Google 能够理解你的网页,并且让有价值的页面进入 Google 的索引数据库。
三、第三步:排名与展示(Ranking & Serving)——Google 如何决定谁排在第一名?
前面两步主要是 Google 在后台完成的工作。
第三步,才是我们平时使用搜索引擎时能够直接看到的部分。
假设现在有人打开 Google,输入:
Best SEO Tools
中文意思是:最好的 SEO 工具。
按下回车键之后,Google 会做什么?
1. Google 首先理解用户的搜索意图
搜索意图(Search Intent)是 SEO 中非常重要的一个概念。
Google 不只是匹配用户输入的关键词,还需要尽可能理解用户真正想要什么。
例如,用户搜索:
| 搜索关键词 | 用户可能想要的内容 |
|---|---|
| What is SEO | 了解 SEO 的定义 |
| Best SEO Tools | 寻找、比较 SEO 工具 |
| Ahrefs Login | 登录 Ahrefs |
| Buy SEO Course | 购买 SEO 课程 |
| How to do keyword research | 学习关键词研究方法 |
虽然这些关键词都与 SEO 有关,但用户的需求完全不同。
如果用户搜索的是 Best SEO Tools,Google 更可能展示工具推荐、产品对比和评测文章,而不是一篇只解释 SEO 定义的文章。
这就是搜索意图的重要性。
2. Google 从索引数据库中寻找相关网页
Google 并不是在用户搜索的那一刻,才开始浏览整个互联网。
它主要是从之前建立好的搜索索引中寻找相关网页。
你可以把它理解为:
图书馆已经提前整理好了所有藏书,当读者提出问题时,工作人员只需要根据目录快速寻找相关书籍。
Google 的搜索系统能够在庞大的索引中快速找到与用户查询相关的网页。
3. Google 如何决定网页排名?
这是 SEO 从业者最关心的问题之一。
假设 Google 找到了 10 万个与某个关键词相关的网页,为什么有些网页排在第一页,有些却排在第 100 页之后?
因为 Google 需要对这些网页进行排序。
Google 官方表示,其搜索排名系统会综合分析大量因素和信号,以便在极短时间内呈现相关、有用的搜索结果。
这些因素可以从以下几个方面理解:
因素一:内容相关性(Relevance)
网页内容是否真正回答了用户的问题?
例如,用户搜索:
How to build a website
如果你的文章详细介绍了建站步骤、工具选择、域名注册和网站发布,那么它就可能与这个搜索需求具有较高的相关性。
因素二:内容质量与实用性(Content Quality & Helpfulness)
网页是否真正帮助用户解决问题?
例如,两篇文章都介绍 SEO:
- A 文章:只有 300 字,内容非常笼统。
- B 文章:有详细的操作步骤、真实案例、数据和实用建议。
如果 B 文章能够更好地满足用户需求,它就可能具有竞争优势。
需要强调的是,文章长度并不是决定排名的标准,内容是否有价值才是关键。
因素三:网站与页面的权威性(Authority)
Google 会利用多种信号评估网页和来源的可信程度。
其中一个重要的历史性排名系统就是 PageRank。
PageRank 最初由 Google 创始人提出,其基本思想是:
一个网页如果获得了其他网页的链接推荐,那么这些链接可以作为衡量其重要性的一种信号。
举个例子:
- 网站 A 获得了 100 个普通网站的链接。
- 网站 B 获得了 10 个相关领域中有影响力的网站的链接。
不能简单地认为 A 一定比 B 更有优势。
链接的来源、相关性及其他信号都可能影响 Google 对页面的判断。
需要注意,PageRank 早已不是一个简单的外链数量计算公式,而是 Google 多种排名系统中的一部分。
因素四:网页体验(Page Experience)
网页是否容易使用,也会影响用户体验。
例如:
- 页面能否在手机上正常浏览?
- 网页加载是否顺畅?
- 是否存在大量干扰阅读的弹窗?
- 页面布局是否稳定?
- 用户能否方便地找到需要的信息?
网页体验很重要,但它并不是一个可以单独决定排名的万能指标。
因素五:内容的新鲜度(Freshness)
不同搜索需求,对内容更新的要求不同。
例如:
- 搜索 2026 年最新 AI 工具:用户更希望看到近期信息。
- 搜索什么是牛顿定律:通常不需要每天更新。
因此,Google 会根据搜索需求判断是否需要优先展示较新的内容。
因素六:用户所在的位置、语言和设备
Google 还会根据搜索上下文提供更合适的结果。
例如,同样搜索:
Best coffee shops
日本东京的用户与美国纽约的用户,看到的结果可能完全不同。
因为他们所在的位置不同,可能需要的咖啡店也不同。
4. Google 最终展示搜索结果
经过相关性判断和排名系统处理后,Google 就会把认为最符合用户需求的结果展示出来。
我们平时看到的 Google 搜索结果页面,通常包含:
- 自然搜索结果(Organic Results)
- 付费广告(Sponsored Results)
- 精选摘要(Featured Snippets)
- 图片结果(Image Results)
- 视频结果(Video Results)
- 本地商家结果(Local Results)
- 其他搜索功能模块
具体展示什么,取决于用户的搜索需求。
例如:搜索一个问题,可能出现精选摘要;搜索餐厅,可能出现地图和本地商家;搜索一款产品,可能出现购物结果。
这里特别说明:自然搜索排名与 Google Ads 广告排名是两套不同的机制。
网站可以通过 SEO 获得自然搜索流量,也可以通过 Google Ads 购买广告展示机会,但广告付费并不会直接让网站的自然排名提高。
四、把三个步骤串起来:Google 搜索引擎的完整工作流程
现在,我们把前面讲的内容串联起来。
假设你今天建立了一个英文工具网站,域名是:
www.myseotool.com你发布了一个关键词研究工具页面:
www.myseotool.com/keyword-research-tool那么,这个页面进入 Google 搜索结果,大致会经历以下过程:
- 发布网页(Publish)你创建网页,发布到互联网上,确保页面可以正常访问。
- 发现网页(Discovery)Google 通过网站链接、外部链接或 Sitemap 等方式发现网页 URL。
- 抓取网页(Crawling)Googlebot 访问网页,获取 HTML、文字、图片等内容。
- 处理与索引(Indexing)Google 分析网页内容、主题、语言及其他信息,判断是否将其加入索引。
- 用户搜索(Search Query)用户输入关键词,例如 Keyword Research Tool。
- 匹配与排名(Ranking)Google 从索引中寻找相关页面,并通过排名系统对结果进行排序。
- 展示搜索结果(Serving)你的网页有机会出现在搜索结果页面中,用户点击后进入网站。
最终目标:让目标用户通过搜索关键词找到你的网页,访问网站,并完成你希望他们完成的操作。
这里有一个非常重要的知识点:
抓取、索引和排名是三个不同的环节。
- 网页被抓取,不代表一定被收录。
- 网页被收录,不代表一定有排名。
- 网页有排名,也不代表一定能获得点击。
这也是为什么很多新手站长会遇到网站已经上线很久,却没有 Google 自然搜索流量的情况。
五、从 SEO 的角度理解搜索引擎工作原理
了解 Google 的工作原理之后,我们就能理解 SEO 到底在做什么了。
SEO(Search Engine Optimization),中文叫搜索引擎优化。
简单来说,SEO 就是通过优化网站内容、结构、技术和其他相关信号,让搜索引擎更容易发现、理解网页,并提高网页获得相关搜索曝光的机会。
结合 Google 的三个核心步骤,我们可以把 SEO 工作分成三个方向。
1. 针对抓取:让 Google 找到你的网站
这一阶段的核心是解决网站的可访问性和网页发现问题。
具体工作包括:
- 网站正常上线,服务器稳定。
- 配置 robots.txt,避免错误阻止重要页面。
- 创建并提交 XML Sitemap。
- 建立合理的网站内部链接。
- 避免重要页面出现孤立页面(Orphan Pages)。
- 确保 Googlebot 可以正常访问重要内容。
例如,你的网站有 100 个工具页面,但这些页面之间没有任何内部链接,也没有出现在 Sitemap 中。
那么 Google 可能很难发现所有页面。
因此,合理的网站结构非常重要。
2. 针对索引:让 Google 理解并收录你的网页
这一阶段的核心是让 Google 明白:
你的网页讲什么?它能解决用户什么问题?
具体工作包括:
- 每个页面设置清晰、准确的 Title。
- 编写能够概括页面内容的 Meta Description。
- 使用合理的 H1、H2、H3 标题结构。
- 围绕用户需求创建有价值的内容。
- 避免大量重复、低价值页面。
- 正确设置 Canonical。
- 检查是否误设置 noindex。
- 确保 JavaScript 渲染不会影响重要内容的识别。
举个例子:假设你开发了一个免费的 BMI Calculator(BMI 计算器)。
那么,你不能只发布一个计算器输入框。
你还可以在页面中提供:
- BMI Calculator 的使用方法。
- BMI 的计算公式。
- BMI 结果如何理解。
- BMI 计算示例。
- 常见问题解答。
这样不仅能帮助用户,也能让搜索引擎更好地理解页面的主题。
3. 针对排名:让你的网页比竞争对手更有竞争力
这一阶段是 SEO 最需要长期投入的部分。
假设用户搜索:
Free BMI Calculator
Google 已经收录了成千上万个相关页面。
你的网站如何获得更好的排名?
可以从以下几个方向努力:
| 优化方向 | 具体做法 |
|---|---|
| 搜索意图 | 确保页面真正满足用户需求 |
| 内容质量 | 提供准确、完整、实用的信息 |
| 产品体验 | 让工具好用、快速、易于操作 |
| 网站结构 | 建立清晰的分类和内部链接 |
| 外部链接 | 获得真实、相关、有价值的网站推荐 |
| 页面体验 | 优化移动端、加载速度和交互体验 |
| 内容维护 | 根据需求变化及时更新内容 |
这里特别强调一点:
SEO 不是简单地在文章中重复关键词,也不是不断购买外链。
真正有效的 SEO,应该从用户需求出发,创建能够解决问题的页面,再通过技术和内容优化,让搜索引擎更容易理解和发现这些页面。
六、新手必须理解的 5 个 SEO 基础概念
如果你准备开始学习 Google SEO,下面这几个概念一定要理解。
| 英文术语 | 中文解释 | 核心含义 |
|---|---|---|
| Crawling | 抓取 | Google 发现并访问网页 |
| Indexing | 索引 / 收录 | Google 分析并保存网页信息 |
| Ranking | 排名 | Google 对相关搜索结果进行排序 |
| SERP | 搜索结果页面 | 用户搜索后看到的页面 |
| Backlink | 外部链接 | 其他网站指向你网站的链接 |
还有几个经常遇到的术语:
- Googlebot:Google 用于抓取网页的爬虫程序。
- Sitemap:网站地图,帮助搜索引擎发现网页。
- robots.txt:告诉爬虫哪些路径可以或不可以抓取。
- Canonical:规范网址,用于帮助搜索引擎识别重复或相似页面中的首选版本。
- Search Intent:搜索意图,也就是用户搜索某个关键词背后的真实需求。
- Organic Traffic:自然搜索流量,不包括付费搜索广告带来的流量。
- SERP Ranking:网页在搜索结果页面中的排名位置。
七、关于 Google 搜索引擎工作原理的常见问题
Q1:新网站上线后,Google 会自动收录吗?
Google 会自动发现大量公开网页,但不保证每个网站或网页都会被抓取和收录。
新网站可以通过 Google Search Console 提交 Sitemap,并使用网址检查工具请求抓取。
Q2:提交 Sitemap 后,多久可以被收录?
没有固定时间。
有些页面可能很快被抓取和收录,有些可能需要更长时间,也有些页面最终不会被收录。
提交 Sitemap 不等于保证收录。
Q3:网页被 Google 收录了,为什么搜索不到?
因为收录和排名是两个不同的概念。
Google 收录了你的页面,并不代表它认为这个页面足够相关或有价值,可以针对你搜索的关键词展示。
另外,排名靠后也可能导致你在常规搜索中很难找到它。
Q4:Google 是否会优先收录大网站?
不能简单这么理解。
Google 会根据网页可访问性、抓取系统安排以及内容等因素处理页面。网站规模并不是保证收录的条件。
小网站同样有机会获得收录和排名。
Q5:付费购买 Google Ads,能让自然搜索排名提高吗?
不能。
Google 官方明确说明,自然搜索排名由自动化系统决定,不会因为你购买 Google Ads 而直接提高。
八、总结:理解搜索引擎,是学习 SEO 的第一步
Google 搜索引擎看起来非常复杂,但对于初学者来说,只需要先掌握三个核心步骤:
- 抓取(Crawling):发现网页。
- 索引(Indexing):理解和存储网页。
- 排名(Ranking):匹配和展示搜索结果。
这三个环节构成了 Google 搜索的基本工作流程。
对于想要通过 Google SEO 获得流量的网站运营者来说,你需要做的事情也很清晰:
- 让 Google 能够发现并抓取你的网站。
- 让 Google 能够理解并收录你的网页。
- 创建比竞争对手更能满足用户需求的内容和产品,争取获得更好的搜索排名。
最后,记住一句话:
SEO 的本质不是讨好搜索引擎,而是发现真实的用户需求,创造有价值的内容或产品,再通过搜索引擎把它们展示给需要的人。
当你真正理解了搜索引擎的工作原理,关键词研究、内容规划、网站结构、内链建设、外链建设等 SEO 工作,就不再是孤立的技巧,而是围绕同一个目标展开的一套完整方法。
九、官方学习资料与延伸阅读
如果想进一步学习,建议优先阅读 Google 官方文档,而不是一开始就学习各种 SEO 技巧。
Google 搜索工作原理(How Google Search Works)
:了解抓取、索引和搜索结果展示的完整流程。
Google 搜索排名系统指南
:了解 Google 如何判断网页排名。
Google SEO 入门指南
:Google 官方提供的 SEO 基础教程。
Google 搜索技术要求
:了解网页进入 Google 搜索索引的基本技术要求。
Google 抓取与索引文档
:深入学习 Sitemap、robots.txt、Canonical 等技术知识。
推荐新手下一步学习顺序
- 搜索引擎工作原理
- 关键词研究与搜索意图分析
- 网站结构与 URL 规划
- 页面 SEO(On-Page SEO)
- 技术 SEO(Technical SEO)
- 外链建设与网站权威性
- Google Search Console 数据分析
给准备做工具站出海的站长一个建议
不要只把 SEO 理解为写文章、做外链和布局关键词。一个工具网站能否获得持续的 Google 自然搜索流量,首先取决于你有没有找到真实的搜索需求,以及你开发的工具能否真正解决这个需求。
关键词带来访问机会,工具创造实际价值,SEO 帮助用户发现你的产品。这三者应该结合起来考虑。